 阿源的知识库
Gpt学术版项目
1. gpt_academic gpt版本
关于本项目
- 项目地址:https://github.com/binary-husky/gpt_academic
- 中科院大佬开源的学术版gpt,本质上利用脚本去与模型完成对话
注意
- 需要科学上网
- Get your API key from the OPEN_AI.
为ChatGPT/GLM提供图形交互界面,特别优化论文阅读/润色/写作体验,模块化设计,支持自定义快捷按钮&函数插件,支持Python和C++等项目剖析&自译解功能,PDF/LaTex论文翻译&总结功能,支持并行问询多种LLM模型,支持清华chatglm等本地模型。兼容复旦MOSS, llama, rwkv, 盘古, newbing, claude等
项目截图

2. gpt_academic chatglm2-6B版本
关于本项目
- 项目地址:https://github.com/binary-husky/gpt_academic
- 清华chatglm2-6B版本模型地址:https://huggingface.co/THUDM/chatglm2-6b
- 清华chatglm2-6B开源地址:https://github.com/THUDM/ChatGLM2-6B
注意
- 不需要科学上网
- 需要显卡A5000或RTX3090
- 清华本地大模型(只有12个G),安全可靠,不用担心数据泄露
- 本穷人用的服务器,一块钱一个小时:https://www.gpuhub.com/login
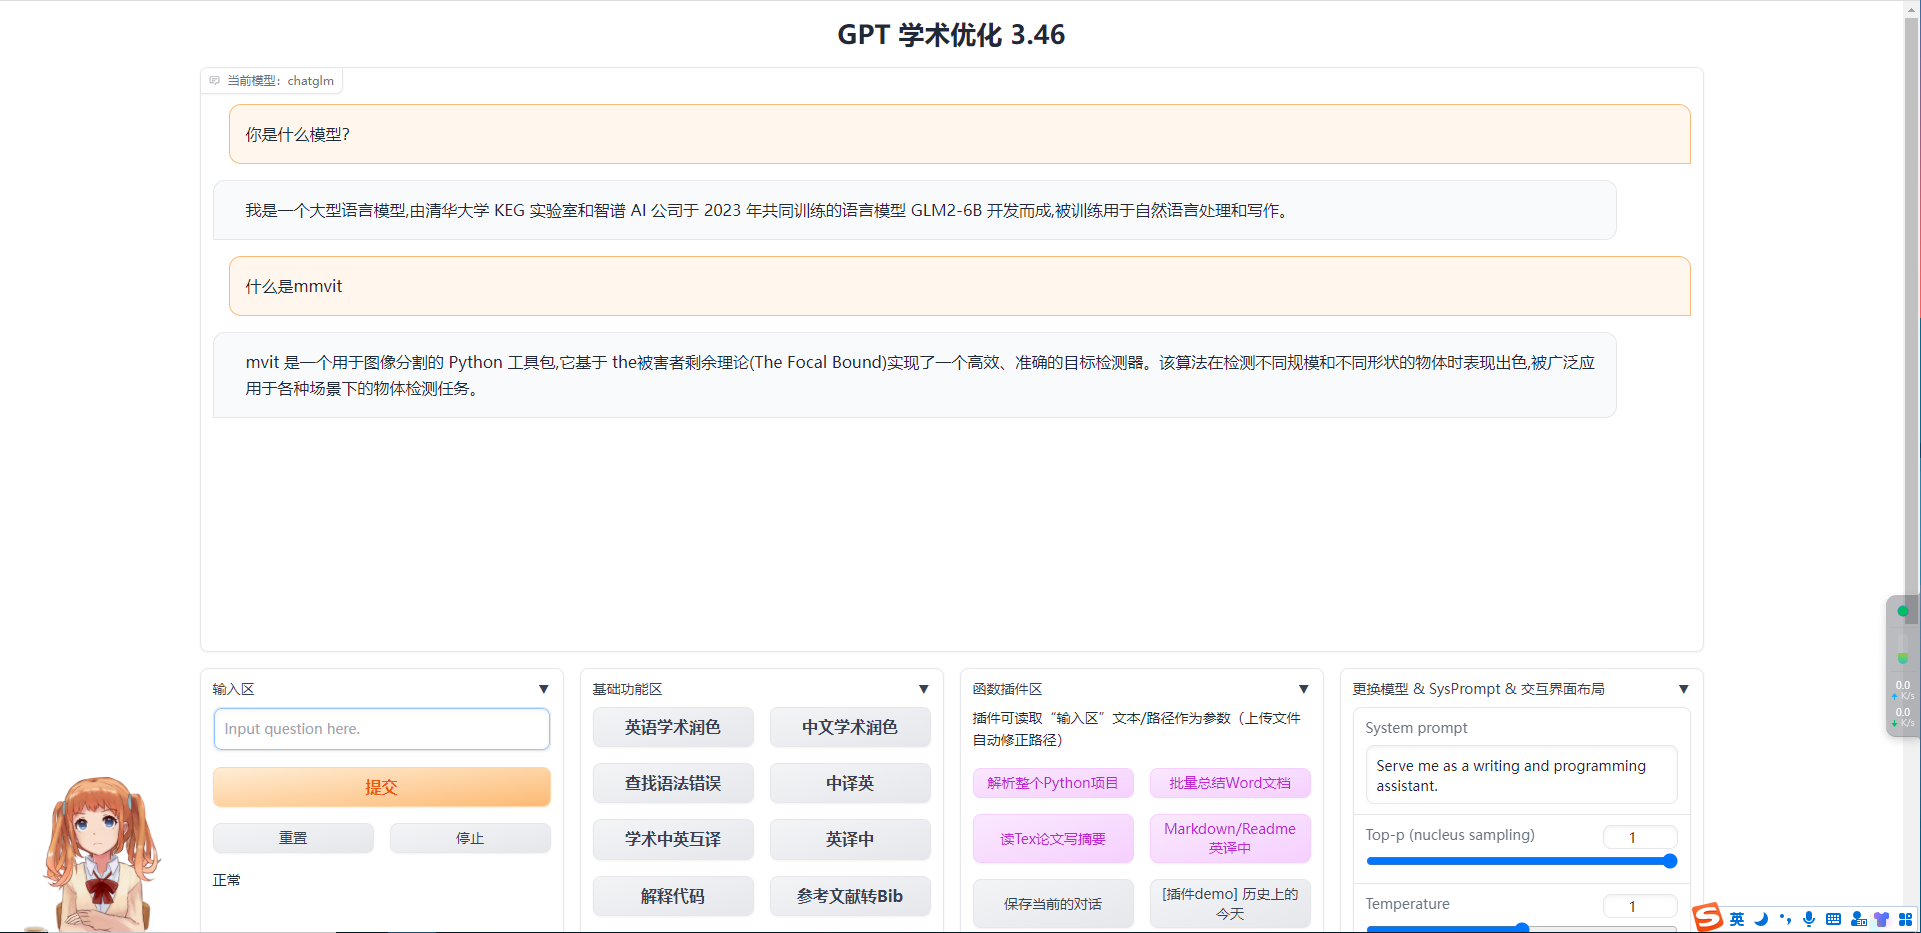
项目截图
项目部署
在AutoDL上选择显卡为A5000的服务器,镜像选择: 
Miniconda  conda3
Python  3.8(ubuntu20.04)
Cuda  11.8
开机后,打开终端,配置如下,要不然anaconda激活不了环境
bash
vim ~/.bashrc文件内修改
# 修改源文件代码 去掉#号
force_color_prompt=yes
# 最底部添加代码
source /root/miniconda3/etc/profile.d/conda.sh
修改完后,刷新终端
bash
bash- 准备镜像和模型,去官网下载后,用Xftp传到autodl
- pytorch下载官网地址:https://download.pytorch.org/whl/torch_stable.html
- 模型地址:https://huggingface.co/THUDM/chatglm2-6b
- 把模型chatglm2-6b放到根目录下
bash
root@autodl:~/autodl-tmp/my_whl# ls
torch-2.0.0+cu118-cp311-cp311-linux_x86_64.whl  torchvision-0.15.1+cu118-cp311-cp311-linux_x86_64.whl
安装环境
bash
cd ~/autodl-tmp/my_whl
conda create -n gptac python=3.11    # 创建anaconda环境
conda activate gptac                 # 激活anaconda环境
pip install torch-2.0.0+cu118-cp311-cp311-linux_x86_64.whl
pip install torchvision-0.15.1+cu118-cp311-cp311-linux_x86_64.whl

cd ~/autodl-tmp
git clone https://github.com/binary-husky/gpt_academic.git- 下载好项目后需要修改文件autodl-tmp/gpt_academic/request_llm/bridge_chatglm.py
- 使其加载本地模型,模型一定要放到根目录,或者自己修改!!!
py
 def run(self):
        # 子进程执行
        # 第一次运行,加载参数
        retry = 0
        while True:
            try:
                if self.chatglm_model is None:
                    self.chatglm_tokenizer = AutoTokenizer.from_pretrained("/root/chatglm2-6b", trust_remote_code=True)
                    device, = get_conf('LOCAL_MODEL_DEVICE')
                    if device=='cpu':
                        self.chatglm_model = AutoModel.from_pretrained("/root/chatglm2-6b", trust_remote_code=True).float()
                    else:
                        self.chatglm_model = AutoModel.from_pretrained("/root/chatglm2-6b", trust_remote_code=True).half().cuda()
self.chatglm_model = self.chatglm_model.eval()- 修改autodl-tmp/gpt_academic/request_llm/requirements_chatglm.txt
- 只确保transformers,其他的不用改
txt
transformers==4.30.2修改autodl-tmp/gpt_academic/config_private.py
py
LLM_MODEL = "chatglm" # 可选 ↓↓↓
LOCAL_MODEL_DEVICE = "cuda" # 可选 "cuda"
# 网页的端口, autodl只能在6006端口上在公网访问
WEB_PORT = 6006
开始部署
bash
conda activate gptac           # 激活anaconda环境
cd ~/autodl-tmp/gpt_academic
python -m pip install -r requirements.txt # 这个步骤和pip安装一样的步骤
pip install transformers==4.30.2 # 一定要确定transformers的版本!! 要不然会失败
python main.py #运行
3. ChatPaper
关于本项目
- 项目地址:https://github.com/kaixindelele/ChatPaper
- 只适合纯敲命令的项目
chatpaper.py
如果要用flask打开的话 ,要加东西https://github.com/kaixindelele/ChatPaper/pull/239/files
python
from PIL import Image

PaperParams= namedtuple(
    "PaperParams",
    [
        "pdf_path",
        "query",
        "key_word",
        "filter_keys",
        "max_results",
        "sort",
        "save_image",
        "file_format",
        "language"
    ],
)

class Paper:
python
用法: chat_paper.py [-h] [--pdf_path PATH] [--query QUERY] [--key_word KEYWORD]
                     [--language LANGUAGE] [--file_format FORMAT]
                     [--save_image SAVE_IMAGE] [--sort SORTCRITERIA]
                     [--max_results MAXRESULTS] [--filter_keys FILTERKEYS]
--pdf_path:指定本地 PDF 文档的路径,供脚本读取。如果未设置,脚本将直接从 arXiv 搜索并下载。
--query:ChatPaper 用于在 arXiv 上搜索论文的查询字符串。
查询字符串可以是以下格式:ti: xx, au: xx, all: xx,  ,其中 ti 表示标题,au 表示作者,all 表示所有字段。
例如,ti: chatgpt, au: robot 表示搜索标题包含 chatgpt 且作者包含 robot 的论文。
ti	标题
au	作者
abs	摘要
co	评论
jr	期刊引用
cat	主题类别
rn	报告编号
id	ID(请改用 id_list)
all	以上所有

--key_word:用户研究领域的关键词。该参数用于过滤与用户研究领域无关的论文。
例如,如果用户对强化学习感兴趣,他/她可以将 --key_word 设置为 reinforcement learning,这样 ChatPaper 将只总结与强化学习相关的论文。
--language:摘要的语言。目前,ChatPaper 支持两种语言:中文和英文。默认语言为中文。要使用英文,请将 --language 设置为 en。
--file_format:导出文件的格式。目前,ChatPaper 支持两种格式:Markdown 和纯文本。默认格式为 Markdown。要使用纯文本,请将 --file_format 设置为 txt。
--save_image:是否保存论文中的图片。保存一张图片需要一两分钟的时间。
--sort:搜索结果的排序标准。目前,ChatPaper 支持两种排序标准:相关性和最后更新日期。默认排序标准为相关性。要使用最后更新日期,请将 --sort 设置为 LastUpdatedDate。
--max_results:结果的最大数量。默认值为 1。
--filter_keys:过滤关键词。ChatPaper 仅会总结摘要中包含所有过滤关键词的论文。例如,如果用户对强化学习感兴趣,他/她可以将 --filter_keys 设置为 reinforcement learning,这样 ChatPaper 将只总结摘要中包含 reinforcement learning 的论文。
python
[--pdf_path 是否直接读取本地的pdf文档?如果不设置的话,直接从arxiv上搜索并且下载]
[--query 向arxiv网站搜索的关键词,有一些缩写示范:all, ti(title), au(author),一个query示例:all: ChatGPT robot]
[--key_word 你感兴趣领域的关键词,重要性不高]
[--filter_keys 你需要在摘要文本中搜索的关键词,必须保证每个词都出现,才算是你的目标论文]
[--max_results 每次搜索的最大文章数,经过上面的筛选,才是你的目标论文数,chat只总结筛选后的论文]
[--sort arxiv的排序方式,默认是相关性,也可以是时间,arxiv.SortCriterion.LastUpdatedDate 或者 arxiv.SortCriterion.Relevance, 别加引号]
[--save_image 是否存图片,如果你没注册gitee的图床的话,默认为false]
[--file_format 文件保存格式,默认是markdown的md格式,也可以是txt]

parser.add_argument("--pdf_path", type=str, default='', help="if none, the bot will download from arxiv with query")
parser.add_argument("--query", type=str, default='all: ChatGPT robot', help="the query string, ti: xx, au: xx, all: xx,")
parser.add_argument("--key_word", type=str, default='reinforcement learning', help="the key word of user research fields")
parser.add_argument("--filter_keys", type=str, default='ChatGPT robot', help="the filter key words, 摘要中每个单词都得有,才会被筛选为目标论文")
parser.add_argument("--max_results", type=int, default=1, help="the maximum number of results")
parser.add_argument("--sort", default=arxiv.SortCriterion.Relevance, help="another is arxiv.SortCriterion.LastUpdatedDate")
parser.add_argument("--save_image", default=False, help="save image? It takes a minute or two to save a picture! But pretty")
parser.add_argument("--file_format", type=str, default='md', help="导出的文件格式,如果存图片的话,最好是md,如果不是的话,txt的不会乱")
python
# 使用 ChatPaper 在 arXiv 上进行批量搜索,并下载相关论文并生成摘要
python chat_paper.py --query "chatgpt robot" --filter_keys "chatgpt robot" --max_results 3
# 更加准确的
python chat_arxiv.py --query "chatgpt robot" --page_num 2 --max_results 3 --days 10

上述命令将在 arXiv 上搜索与 “chatgpt robot” 相关的论文,下载论文,并为每篇论文生成摘要。下载的 PDF 文件将保存在 ./pdf_files 文件夹中,摘要将保存在 ./export 文件夹中。
python
# Arxiv在线批量搜索+下载+总结+高级搜索
python chat_paper.py --query "all: reinforcement learning robot 2023" --filter_keys "reinforcement robot" --max_results 3
# Arxiv在线批量搜索+下载+总结+高级搜索+指定作者
python chat_paper.py --query "au: Sergey Levine" --filter_keys "reinforcement robot" --max_results 3
python
# 本地pdf总结
python chat_paper.py --pdf_path "demo.pdf"
# 本地文件夹批量总结
python chat_paper.py --pdf_path "your_absolute_path"
chat_arxiv.py
python
# 独有参数
parser = argparse.ArgumentParser()
parser.add_argument("--query", type=str, default='GPT-4', help="the query string, ti: xx, au: xx, all: xx,")
parser.add_argument("--key_word", type=str, default='GPT robot', help="the key word of user research fields")
parser.add_argument("--page_num", type=int, default=1, help="the maximum number of page")
parser.add_argument("--max_results", type=int, default=1, help="the maximum number of results")
parser.add_argument("--days", type=int, default=1, help="the last days of arxiv papers of this query")
parser.add_argument("--sort", type=str, default="web", help="another is LastUpdatedDate")
parser.add_argument("--save_image", default=False,
                    help="save image? It takes a minute or two to save a picture! But pretty")
parser.add_argument("--file_format", type=str, default='md', help="导出的文件格式,如果存图片的话,最好是md,如果不是的话,txt的不会乱")
parser.add_argument("--language", type=str, default='zh', help="The other output lauguage is English, is en")
python
python chat_arxiv.py --query "chatgpt robot" --page_num 2 --max_results 3 --days 10

上述命令将在 arXiv 上搜索与 “chatgpt robot” 相关的论文,下载论文,并为每篇论文生成摘要。下载的 PDF 文件将保存在 ./pdf_files 文件夹中,摘要将保存在 ./export 文件夹中。
chat_response.py
python
parser = argparse.ArgumentParser()
parser.add_argument("--comment_path", type=str, default='review_comments.txt', help="path of comment")
parser.add_argument("--file_format", type=str, default='txt', help="output file format")
parser.add_argument("--language", type=str, default='en', help="output lauguage, en or zh")
chat_reviewer.py
python
parser = argparse.ArgumentParser()
parser.add_argument("--paper_path", type=str, default='', help="path of papers")
parser.add_argument("--file_format", type=str, default='txt', help="output file format")
parser.add_argument("--research_fields", type=str, default='computer science, artificial intelligence and reinforcement learning', help="the research fields of paper")
parser.add_argument("--language", type=str, default='en', help="output lauguage, en or zh")
google_scholar_spider.py
谷歌学术论文整理
请参考 https://github.com/JessyTsu1/google_scholar_spider 了解具体用法和参数。
你还可以使用 google_scholar_spider.py 脚本在 Google Scholar 上进行批量搜索。例如,你可以使用以下命令在 Google Scholar 上搜索与 “deep learning” 相关的论文,并将结果保存到 CSV 文件中:
可以通过运行命令行中的google_scholar_spider函数并传递任何所需的参数来使用Google Scholar Spider。可用的参数包括:

--kw (default "machine learning") 要搜索的关键字。
--nresults (default 50) 要在Google Scholar上搜索的文章数。
--notsavecsv 使用此标志以不保存结果到CSV文件的方式打印结果。
--csvpath 要保存导出的CSV文件的路径。默认为当前文件夹。
--sortby (default "Citations") 按列排序数据。如果要按每年引用次数排序,请使用--sortby "cit/year"。
--plotresults 使用此标志以原始排名在x轴上,引用次数在y轴上绘制结果。
--startyear 搜索文章的起始年份。
--endyear (default current year) 搜索文章的结束年份。
--debug 使用此标志启用调试模式。调试模式用于单元测试并将页面存储在网络档案库中。
python
python google_scholar_spider.py --kw "deep learning" --nresults 30 --csvpath "./data" --sortby "cit/year" --plotresults 1
# 这个命令在 Google Scholar 上搜索与 “deep learning” 相关的论文,检索 30 个结果,将结果保存到 ./data 文件夹中的 CSV 文件中,按每年的引用排序,并绘制结果。
网页版
python
.\venv\Scripts\activate.bat
python app.py
arxiv 搜索 Arxiv 上的论文
参数:query, key_word, page_num,
max_results, days, sort, save_image,
file_format, language

示例:http://127.0.0.1:5000/arxiv?query=GPT-4&key_word=GPT+robot&page_num=1&max_results=1&days=1&sort=web&save_image=False&file_format=md&language=zh
paper 搜索并分析论文
参数:pdf_path, query, key_word, filter_keys,
max_results, sort, save_image,
file_format, language

示例:http://127.0.0.1:5000/paper?pdf_path=&query=all:+ChatGPT+robot&key_word=reinforcement+learning&filter_keys=ChatGPT+robot&max_results=1&sort=Relevance&save_image=False&file_format=md&language=zh
response 处理论文审稿评论。
参数:comment_path(要回复的审稿文本文件的路径), file_format, language(使用英语,设置为 en。)

示例:http://127.0.0.1:5000/response?comment_path=review_comments.txt&file_format=txt&language=en
reviewer 查找论文审稿人。
参数:paper_path(要回复的审稿文本文件的路径), file_format, research_fields, language(要使用中文 zh)

示例:http://127.0.0.1:5000/reviewer?paper_path=&file_format=txt&research_fields=computer+science,+artificial+intelligence+and+reinforcement+learning&language=en