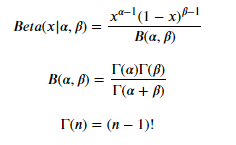阿源的知识库
几种分布
8. 几种分布
1. 正太分布
正态分布代表了宇宙中大多数情况的运转状态。大量的随机变量被证明是正态分布的。
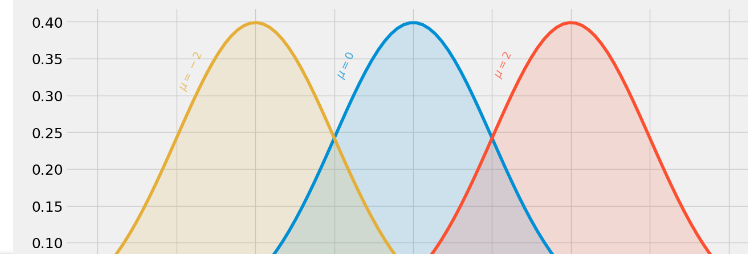
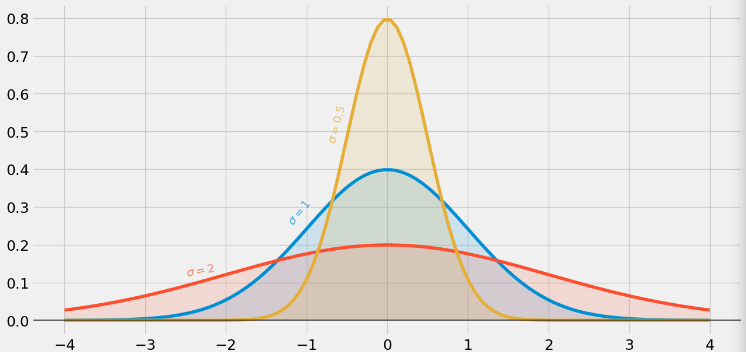
若随机变量X服从一个数学期望为μ、方差为σ^2的正态分布,记为N(μ,σ^2)。其概率密度函数为正态分布的期望值μ决定了其位置,其标准差σ决定了分布的幅度。当μ = 0,σ = 1时的正态分布是标准正态分布。
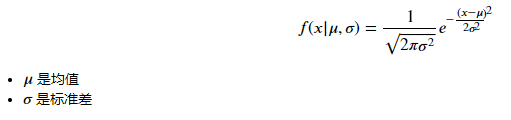
plt.figure(dpi=100)

##### COMPUTATION #####
# DECLARING THE "TRUE" PARAMETERS UNDERLYING THE SAMPLE
mu_real = 10
sigma_real = 2

# DRAW A SAMPLE OF N=1000
np.random.seed(42)
sample = stats.norm.rvs(loc=mu_real, scale=sigma_real, size=1000)

# ESTIMATE MU AND SIGMA
mu_est = np.mean(sample)
sigma_est = np.std(sample)
print("Estimated MU: {}\nEstimated SIGMA: {}".format(mu_est, sigma_est))

##### PLOTTING #####
# SAMPLE DISTRIBUTION
plt.hist(sample, bins=50,normed=True, alpha=.25)

# TRUE CURVE
plt.plot(np.linspace(2, 18, 1000), norm.pdf(np.linspace(2, 18, 1000),loc=mu_real, scale=sigma_real))

# ESTIMATED CURVE
plt.plot(np.linspace(2, 18, 1000), norm.pdf(np.linspace(2, 18, 1000),loc=np.mean(sample), scale=np.std(sample)))

# LEGEND
plt.text(x=9.5, y=.1, s="sample", alpha=.75, weight="bold", color="#008fd5")
plt.text(x=7, y=.2, s="true distrubtion", rotation=55, alpha=.75, weight="bold", color="#fc4f30")
plt.text(x=5, y=.12, s="estimated distribution", rotation=55, alpha=.75, weight="bold", color="#e5ae38")

# TICKS
plt.tick_params(axis = 'both', which = 'major', labelsize = 18)
plt.axhline(y = 0, color = 'black', linewidth = 1.3, alpha = .7)

# TITLE
plt.text(x = 0, y = 0.3, s = "Normal Distribution",
               fontsize = 26, weight = 'bold', alpha = .75)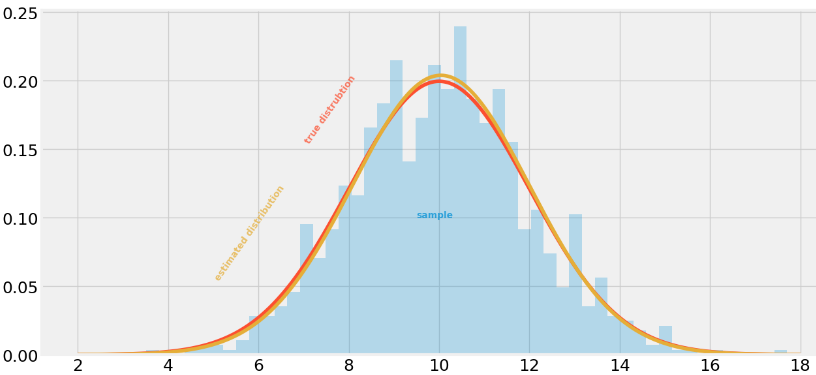
2. 二项分布
让我们来看看玩板球这个例子。假设你今天赢了一场比赛,这表示一个成功的事件。你再比了一场,但你输了。如果你今天赢了一场比赛,但这并不表示你明天肯定会赢。我们来分配一个随机变量X,用于表示赢得的次数。 X可能的值是多少呢?它可以是任意值,这取决于你掷硬币的次数。

只有两种可能的结果,成功和失败。因此,成功的概率 = 0.5,失败的概率可以很容易地计算得到:q = p – 1 = 0.5。

二项式分布就是只有两个可能结果的分布,比如成功或失败、得到或者丢失、赢或败,每一次尝试成功和失败的概率相等。

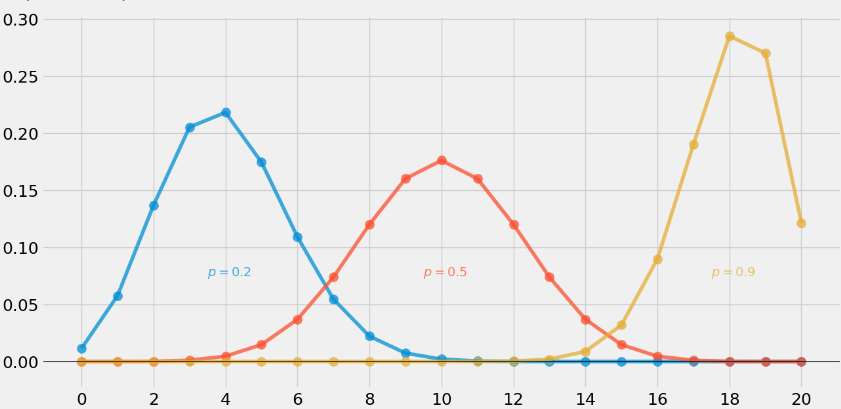
结果有可能不一定相等。如果在实验中成功的概率为0.2,则失败的概率可以很容易地计算得到 q = 1 - 0.2 = 0.8。

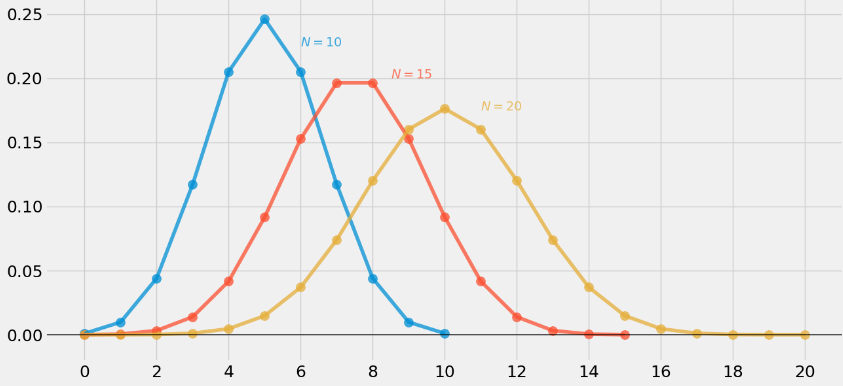
每一次尝试都是独立的,因为前一次投掷的结果不能决定或影响当前投掷的结果。只有两个可能的结果并且重复n次的实验叫做二项式。二项分布的参数是n和p,其中n是试验的总数,p是每次试验成功的概率。

在上述说明的基础上,二项式分布的属性包括:

- 每个试验都是独立的。
- 在试验中只有两个可能的结果:成功或失败。
- 总共进行了n次相同的试验。
- 所有试验成功和失败的概率是相同的。 (试验是一样的)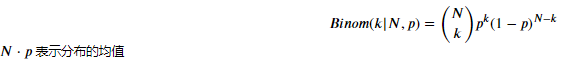
PMF( 概率质量函数 ): 是对 离散随机变量 的定义. 是 离散随机变量 在各个特定取值的概率. 该函数通俗来说,就是 对于一个离散型概率事件来说, 使用这个函数来求它的各个成功事件结果的概率.
PDF ( 概率密度函数 ): 是对 连续性随机变量 的定义. 与PMF不同的是 PDF 在特定点上的值并不是该点的概率, 连续随机概率事件只能求一段区域内发生事件的概率, 通过对这段区间进行积分来求. 通俗来说, 使用这个概率密度函数 将 想要求概率的区间的临界点( 最大值和最小值)带入求积分. 就是该区间的概率.
3. 泊松分布
现实生活多数服从于泊松分布
假设你在一个呼叫中心工作,一天里你大概会接到多少个电话?它可以是任何一个数字。现在,呼叫中心一天的呼叫总数可以用泊松分布来建模。这里有一些例子:
- 医院在一天内录制的紧急电话的数量。
- 某个地区在一天内报告的失窃的数量。
- 在一小时内抵达沙龙的客户人数。
- 在特定城市上报的自杀人数。
- 书中每一页打印错误的数量。 泊松分布适用于在随机时间和空间上发生事件的情况,其中,我们只关注事件发生的次数。
当以下假设有效时,则称为泊松分布
- 任何一个成功的事件都不应该影响另一个成功的事件。
- 在短时间内成功的概率必须等于在更长的间内成功的概率。
- 时间间隔很小时,在给间隔时间内成功的概率趋向于零。
泊松分布中使用了这些符号:
λ是事件发生的速率
t是时间间隔的长
X是该时间间隔内的事件数。
其中,X称为泊松随机变量,X的概率分布称为泊松分布。
令μ表示长度为t的间隔中的平均事件数。那么,µ = λ*t。
例如说一个医院中,每个病人来看病都是随机并独立的概率,则该医院一天(或者其他特定时间段,一小时,一周等等)接纳的病人总数可以看做是一个服从poisson分布的随机变量。但是为什么可以这样处理呢? 通俗定义:假定一个事件在一段时间内随机发生,且符合以下条件:
- (1)将该时间段无限分隔成若干个小的时间段,在这个接近于零的小时间段里,该事件发生一次的概率与这个极小时间段的长度成正比。
- (2)在每一个极小时间段内,该事件发生两次及以上的概率恒等于零。
- (3)该事件在不同的小时间段里,发生与否相互独立。
则该事件称为poisson process。这个第二定义就更加利于大家理解了,回到医院的例子之中,如果我们把一天分成24个小时,或者24x60分钟,或者24x3600秒。时间分的越短,这个时间段里来病人的概率就越小(比如说医院在正午12点到正午12点又一毫秒之间来病人的概率是不是很接近于零?)。 条件一符合。另外如果我们把时间分的很细很细,是不是同时来两个病人(或者两个以上的病人)就是不可能的事件?即使两个病人同时来,也总有一个人先迈步子跨进医院大门吧。条件二也符合。倒是条件三的要求比较苛刻。应用到实际例子中就是说病人们来医院的概率必须是相互独立的,如果不是,则不能看作是poisson分布。
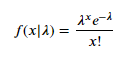

4. 均匀分布
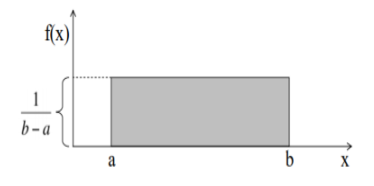
对于投骰子来说,结果是1到6。得到任何一个结果的概率是相等的,这就是均匀分布的基础。与伯努利分布不同,均匀分布的所有可能结果的n个数也是相等的。
如果变量X是均匀分布的,则密度函数可以表示为:
5. 卡方分布
通俗的说就是通过小数量的样本容量去预估总体容量的分布情况

卡方检验就是统计样本的实际观测值与理论推断值之间的偏离程度

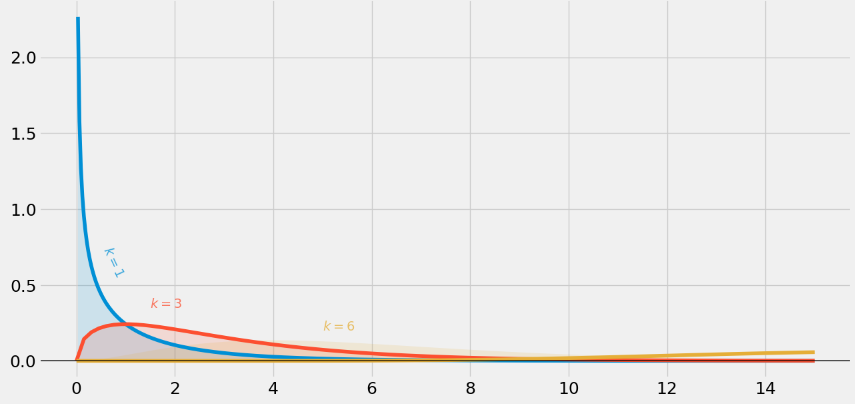
若n个相互独立的随机变量ξ₁,ξ₂,...,ξn ,均服从标准正态分布(也称独立同分布于标准正态分布),则这n个服从标准正态分布的随机变量的平方和构成一新的随机变量,其分布规律称为卡方分布(chi-square distribution)

自由度:假设你现在手头有 3 个样本,。因为样本具有随机性,所以它们取值不定。但是假设出于某种原因,我们需要让样本均值固定,比如说,  , 那么这时真正取值自由,”有随机性“ 的样本只有 2 个。 试想,如果  ,那么每选取一组  的取值,  将不得不等于  对于第三个样本来说,这种 “不得不” 就可以理解为被剥夺了一个自由度。所以就这个例子而言,3 个样本最终"自由"的只有其中的 2 个。不失一般性,  个样本, 留出一个自由度给固定的均值,剩下的自由度即为  。

卡方检验的基本思想是根据样本数据推断总体的频次与期望频次是否有显著性差异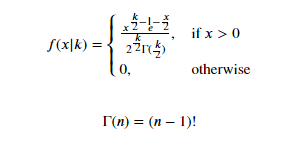
6. beta分布
beta分布可以看作一个概率的概率分布,当你不知道一个东西的具体概率是多少时,它可以给出了所有概率出现的可能性大小

举一个简单的例子,熟悉棒球运动的都知道有一个指标就是棒球击球率(batting average),就是用一个运动员击中的球数除以击球的总数,我们一般认为0.266是正常水平的击球率,而如果击球率高达0.3就被认为是非常优秀的。现在有一个棒球运动员,我们希望能够预测他在这一赛季中的棒球击球率是多少。你可能就会直接计算棒球击球率,用击中的数除以击球数,但是如果这个棒球运动员只打了一次,而且还命中了,那么他就击球率就是100%了,这显然是不合理的,因为根据棒球的历史信息,我们知道这个击球率应该是0.215到0.36之间才对啊。对于这个问题一个最好的方法就是用beta分布,这表示在我们没有看到这个运动员打球之前,我们就有了一个大概的范围。beta分布的定义域是(0,1)这就跟概率的范围是一样的。接下来我们将这些先验信息转换为beta分布的参数,我们知道一个击球率应该是平均0.27左右,而他的范围是0.21到0.35,那么根据这个信息,我们可以取α=81,β=219(击中了81次,未击中219次)

之所以取这两个参数是因为:

beta分布的均值是从图中可以看到这个分布主要落在了(0.2,0.35)间,这是从经验中得出的合理的范围。
在这个例子里,我们的x轴就表示各个击球率的取值,x对应的y值就是这个击球率所对应的概率。也就是说beta分布可以看作一个概率的概率分布。